我们不会说中文*,但 Soniox 的语音识别 API 能把中文语音准确地转成文字。
实时语音转文字 API,中文识别准确,支持中英混说、人名、数字和编号。可以直接在下面的演示中试用中文语音识别。
也可以试试 Soniox Text-to-Speech
*所以这个页面是由 AI 翻译的。
Trusted by teams building global voice products







中文语音识别模型
Soniox 的语音识别模型(ASR)准确转写自然对话中的中文,包括说话人切换、中英混说以及人名、数字和编号,实时流式识别和录音文件转写都适用。
语音识别 API 功能
一个 API 覆盖实时语音转文字、录音文件转写、说话人分离、语言识别和实时翻译。
实时流式识别
通过 WebSocket 推送音频流,边说边返回识别结果,无需等待整句结束。
录音文件转写
上传录音或音频文件进行异步转写,适合会议录音、通话和媒体内容。
端点检测
判断说话人是否真正说完一句话,而不只是停顿,让语音智能体在合适的时机回应。
说话人分离
实时区分不同说话人,转写结果清楚标出每句话由谁所说。
中英混说
自动识别语言,说话人在句中切换中文和英文时也能准确转写,无需预先指定语言。
上下文与专业术语
提供公司名、产品名、人名或行业术语等上下文,提升专业词汇的识别准确率,无需重新训练模型。
实时语音翻译
把中文语音实时翻译成英语等 60 多种语言,支持单向和双向翻译。
时间戳和置信度
每个识别结果都带有时间戳和置信度分数,便于制作字幕、建立检索索引和质量筛选。
适配 AI 编程工具
把 Soniox 文档接入 Cursor、Claude 等 AI 编程工具,快速生成集成代码。
中文语音识别应用场景
从语音智能体、会议转写到呼叫中心和实时翻译,中文语音识别已经用于这些场景。
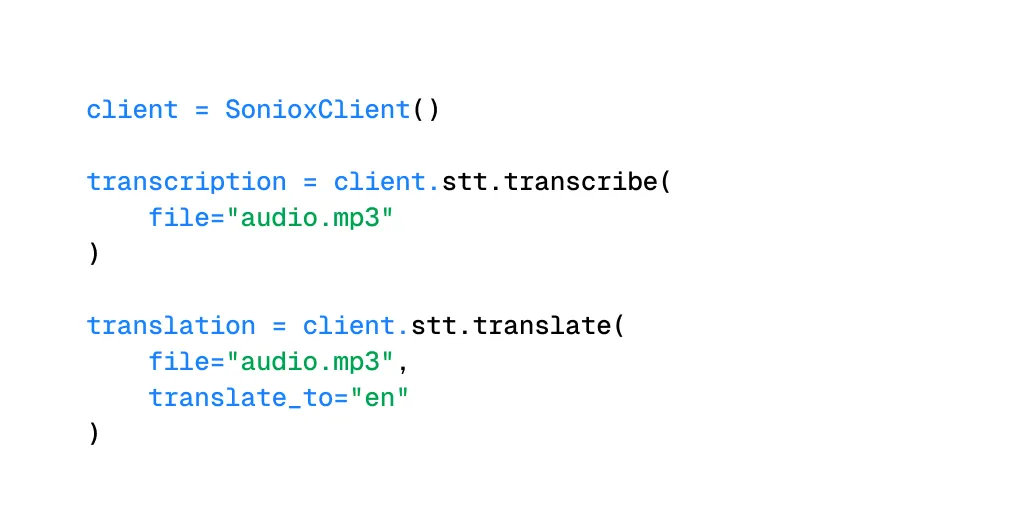
官方 SDK 和示例代码
提供 Python、Node.js、Web、React 和 React Native 官方 SDK,可以直接在现有技术栈中集成语音识别。
隐私保护与合规
数据不用于训练模型
通过 API 发送的音频、转写内容和元数据,绝不会用于训练或改进 Soniox 模型。
按区域处理和存储数据
可选区域:US、EU、Japan、India。音频和转写内容在所选区域内完成处理和存储。
符合主流安全与合规标准
适用于医疗、企业等对语音数据保密要求较高的行业。